見えない駒を読むAIが、世界屈指の選手に勝ち越した — 20戦15勝を支えたAtaraxosの新手法
見えない駒を読むAIが、世界屈指の選手に勝ち越した — 20戦15勝を支えたAtaraxosの新手法
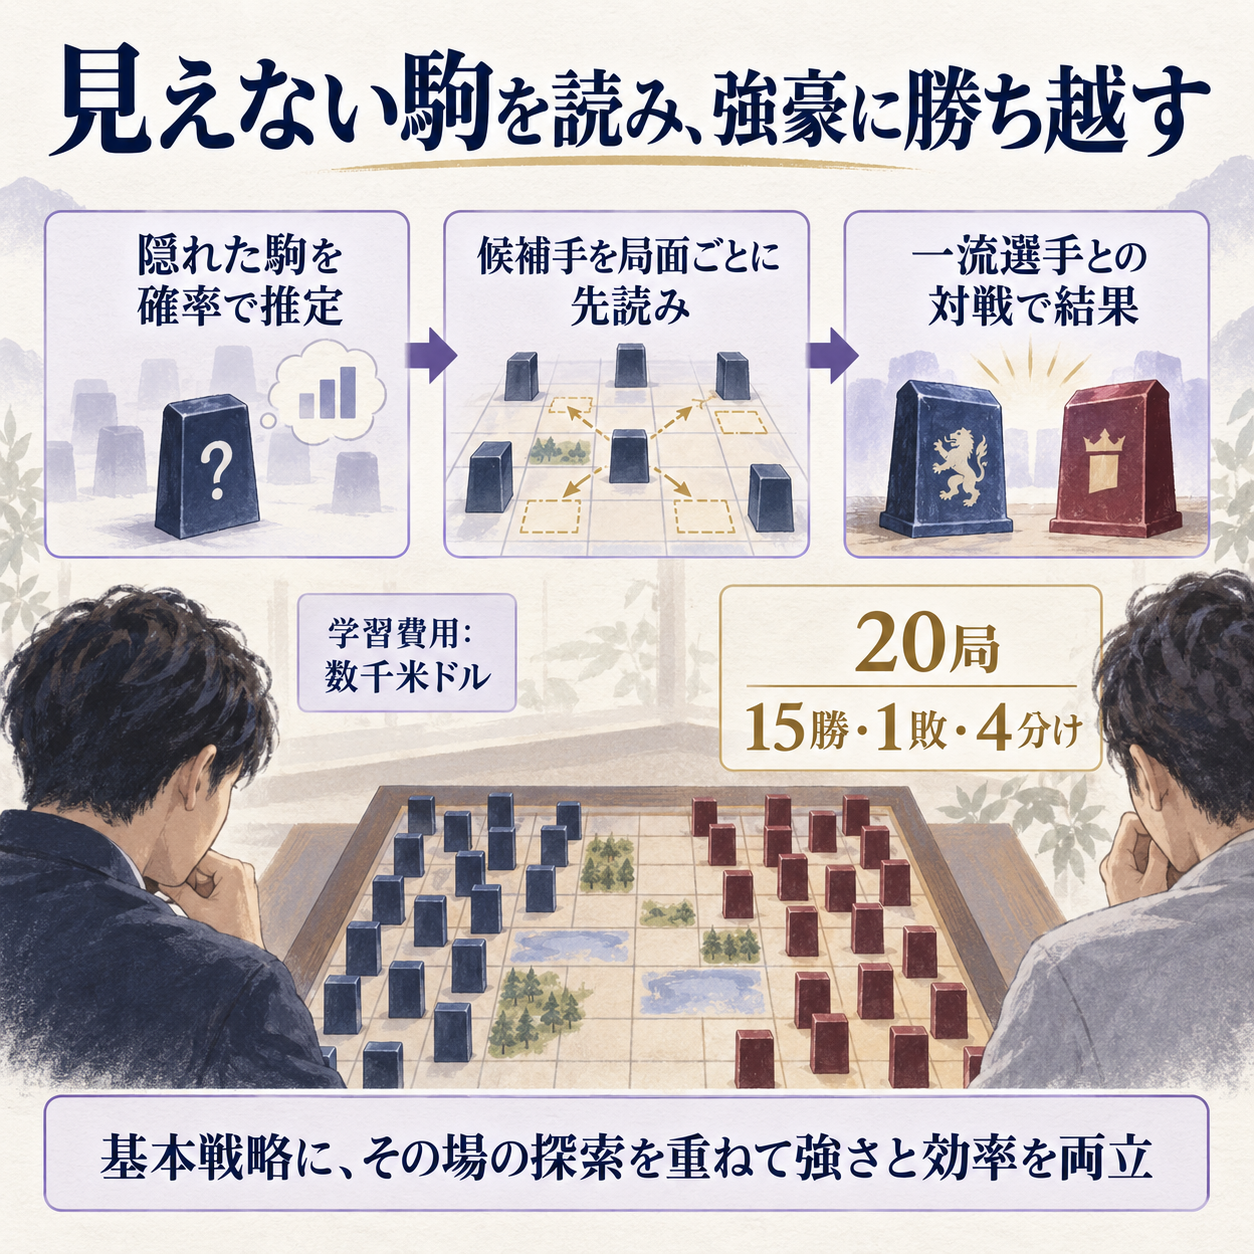
相手の駒の正体が分からない盤上ゲームで、研究チームのAIが世界屈指の競技者に勝ち越しました。
対戦結果が示したもの
この研究の強さは、最も実績ある競技者との長い対戦で結果を出した点にあります。
米MIT、カーネギーメロン大学、ニューヨーク大学、スタンフォード大学の研究者が開発したAtaraxosは、2026年9月30日付のNature論文で公表されました。
題材のStratego(ストラテゴ)は、互いに40個の駒を秘密の配置で並べる2人用ゲームです。
駒同士がぶつかるまで相手の駒の種類は分からず、プレイヤーは勝負のために情報を集める一方、自分の強い駒や作戦も悟らせないように動きます。
盤面がすべて見えるチェスより、相手の意図を読む仕事が一段加わります。
Nature論文に記載されたPim Niemeijerとの20局では、Ataraxosは15勝1敗4分けでした。
Niemeijerは世界選手権優勝4回などの実績を持つ競技者です。
引き分けを含む20局を通じて、単発の勝利ではなく、複数局で優位を保てるかを試しています。
研究チームは、学習に使う費用を数千米ドルに抑えたと報告しました。
MITの研究紹介では、先行するDeepNash(ディープナッシュ)との比較で、訓練例は100分の1未満、自己対戦のゲーム数は30分の1未満だったとしています。
ここで比べているのはAIの学習効率です。
AtaraxosとDeepNashを同じ条件で直接対戦させた結果ではありません。
この対戦は、研究室内で同じ設定を繰り返しただけではありません。
相手はAtaraxosの作戦に弱点がないかを探る機会があり、AI側は相手の対局ごとの動きに合わせて学び直す設定ではありませんでした。
人間がAIの癖に気づいて対抗できる条件を含めて試した点は、単純な自己対戦の勝率より現実に近い検証です。
それでも20局は、あらゆる戦略や競技者を網羅した結果ではありません。
論文も、対戦を重ねるなかで相手が作戦を変えるため、試合を独立した試行とは言いにくいと説明しています。
したがって「人間より常に強い」と一般化するより、難関ゲームの最上位選手との条件つき対戦で、人間を上回る結果が得られたと読むのが正確です。
なぜ、隠れた情報でも手を選べるのか
Ataraxosは、長期戦略を学ぶ仕組みと、目の前の盤面に合わせて考え直す仕組みを組み合わせています。
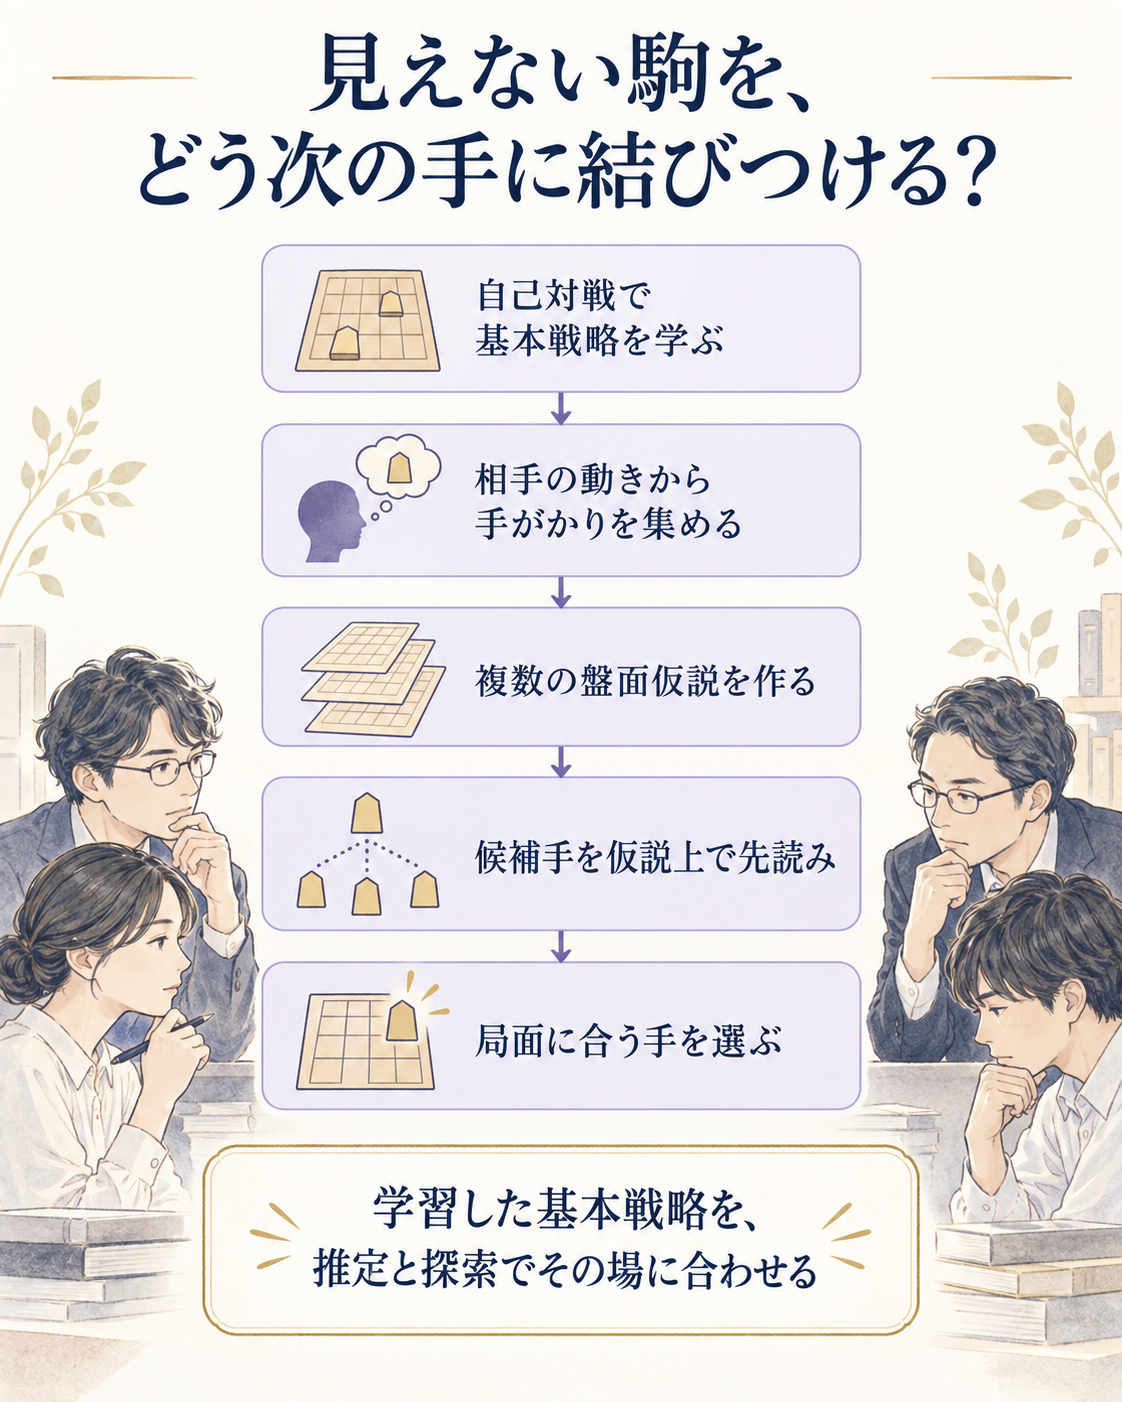
まず自己対戦型の強化学習(自分同士の対局から勝ち方を学ぶ方法)で、基本となる戦略を作ります。何度も対局する中で、どの配置や動かし方が勝ちにつながるかを少しずつ覚えていきます。
ただし、覚えた手順をそのまま繰り返すだけでは、相手の作戦に対応できません。
そこで、信念モデル(見えない駒の種類を確率で推測する仕組み)を用意します。
戦いで露出した駒、移動できる範囲、相手がまだ動かしていない駒などを手がかりに、「この場所にはどの駒がありそうか」を複数の仮説として組み立てます。
手番ごとに候補手を仮説上の盤面へ当てはめ、先の展開を比べるのが意思決定時の探索(手を動かす直前に、先の展開を試す計算)です。
基本戦略が大きな地図だとすれば、探索は現在地と相手の様子を見ながら進路を修正する役目です。
可能性を全部並べ尽くすのではなく、ありそうな盤面を選んで検討するため、計算を使う場所を絞れます。
この組み合わせは、ゲーム木探索(あらゆる次の手を枝分かれで調べる方法)が重くなりやすい問題への工夫でもあります。
DeepMindが2022年に公表したDeepNashは、ゲーム理論(相手の選択も考え、自分に有利な手を探す考え方)と強化学習を使い、オンラインのStrategoで人間上位層に入る成績を出しました。
Ataraxosの論文は、巨大な探索空間でも学習と探索を組み合わせられること、しかもデータや計算を抑えられることを示しています。
両者の実績は評価時期・条件が異なるため、単純な順位表にはできません。
少ない学習データで済んだ理由は、一度学習した戦略を、対局時の盤面に合わせて使い直す設計にあります。
すべての手筋を学習段階で覚え込ませるのではなく、相手の駒についてもっともありそうな仮説を作り、その局面で必要な手だけを追加で探索します。
研究紹介が示すデータ量の差は、この「事前に全部覚える」方法から「基本を学び、必要なときに考え直す」方法へ移る効率を表しています。
その効率は、訓練コストをそのまま現場の導入費に置き換えられるという意味ではありません。
今回の実験では、ルールが決まったゲームを大量に動かす専用シミュレーターを用意できました。
企業の商談やサプライチェーンでは、相手の行動だけでなく、契約条件、納期、供給制約も変わります。
まずその状況をどこまで模擬できるかが、AIの能力より先に問われます。
実務へ移す前に必要な条件
今回の結果が示すのは「AIが交渉を人間よりうまく行う」ことではなく、隠れた情報を含む、ルールの決まった環境なら戦略を学習できる可能性です。
Nature論文は、同じ手法をBarrage Stratego(駒数を減らした短縮版)、Hanabi(協力型カードゲーム)、Dou dizhu(中国のチーム型カードゲーム)にも応用し、別のゲームで強い成績を得たと報告しています。
攻守が入れ替わるゲーム、協力ゲーム、チーム戦で共通の設計が動いた点は、Strategoだけに合わせた仕掛けではないことを示す材料です。
特にBarrage Strategoでは、世界選手権経験者を含む上位選手3人との4シリーズを行い、Ataraxosが各シリーズに勝ちました。
Hanabiでは既存の最高成績を更新し、Dou dizhuでは当時の強いボットを破ったと論文は報告しています。
ゲームを変えても同じ構成が働くことは、応用先を広げる材料ですが、まだゲーム内の評価です。
業務判断での精度や経済的な効果を測ったものではありません。
交渉や調達では、相手の原価、在庫、優先順位が見えないことがあります。
ここへ応用できるかは推論ですが、契約条件や選択肢を模擬できる環境に落とし込み、AIに複数の交渉案を試させる使い方は考えられます。
予算編成でも、競合の値下げや仕入れ制約を変数として動かせば、計画がどの条件で崩れるかを先に洗い出せます。
ただし、この方法の強みはシミュレーター(状況を仮想的に動かして結果を試すソフト)を高速に動かせることにも支えられています。
現実の交渉には、固定されたルールも、勝敗を一つの数字で測る基準もありません。
人間が途中で目的を変えたり、関係維持を優先したりすれば、ゲーム用に作った勝ち負けの評価基準は、現場で大切な価値を取り違える可能性があります。
研究チームは、モデルの判断を人間が理解・監査できる仕組みを今後の課題に挙げています。
実務では、AIが出した「最善案」だけでなく、前提条件、採らなかった選択肢、結論を変えた情報まで見える必要があります。
勝率の高い戦略を作れることと、組織がその助言を安全に使えることは別の課題です。
見立てと監視ポイント
次に確かめたいのは、別の環境でも再現するか、そして判断理由を人が追えるかです。
公開された研究結果は、シミュレーションを使った戦略AIが大規模な隠れ情報を扱えるという強い証拠になりました。
一方、企業や行政の実務で使える段階に達したことを意味しません。
今後は、第一に、第三者が同じ訓練条件を再現できるか。
第二に、対戦相手やルールを変えても性能を保つか。
第三に、利用者が判断の根拠と失敗条件を監査できるかを見ます。
特に、同じモデルが得意な環境だけで評価されていないかを確認する必要があります。
腹落ち確認の問い
AIが限られた対戦で人間の一流選手に勝ち越したとき、実務で使えると判断するために、勝率以外にどんな証拠が必要でしょうか。
考え方
勝率は、試した相手・ルール・評価指標の範囲での成績です。
実務へ広げる前に、条件を変えた再現性、前提が外れたときの振る舞い、判断理由を人が点検できるかを確認します。
現場に近いシミュレーターの精度と、誤った助言を止める手順も欠かせません。
もっと詳しく知りたい人へ
- Nature掲載論文 — 学習方法、20局の評価、複数ゲームへの応用を確認できます。
- MIT Newsの研究紹介 — 開発者の説明と学習効率の比較を平易に読めます。
- Ars Technicaの独立取材 — 20局の対戦条件や、論文が報告する別ゲームでの結果を整理しています。
- Google DeepMindのDeepNash解説 — 先行AIがStrategoで使った考え方と当時の成績が分かります。
- Ataraxosの対局記録 — 論文が案内する20局の記録を確認できます。
- 情報・通信業業界基礎ガイド — AIを含む情報・通信業の事業領域と収益構造を整理できます。
出典
- 一次資料: Nature「Scalable decision-making for games of imperfect information」(2026-09-30)— https://www.nature.com/articles/s41586-026-11036-y 。直接取得はNatureの認証画面で失敗し、r.jina.ai経由の再取得もできませんでした。検索結果に収録された論文本文で掲載日と主要事実を確認しました。
- 補助確認: MIT News「This game-playing AI is the new champ at Stratego」(2026-09-30)— https://news.mit.edu/2026/game-playing-ai-stratego-new-champ-0930 。Ars Technica「With most information hidden, the game Stratego had stumped AI—until now」(2026-10-01)— https://arstechnica.com/science/2026/10/ai-finally-beat-the-best-stratego-player-in-history-and-did-it-on-a-budget/ 。両ページを直接開き、論文名、対戦条件、主な成績を照合しました。
- 反証確認: 2025年の大会デモ成績はMIT Newsが39勝2敗、Nature論文とArs Technicaが40局38勝2敗と異なります。本記事では不一致のある大会デモ数値を使わず、三資料で一致するPim Niemeijerとの20局15勝1敗4分けのみを記載しました。
- 比較資料: Google DeepMind「Mastering Stratego, the classic game of imperfect information」(2022-12-01)。DeepNashの当時の方法とGravonでの順位を照合しました。Ataraxosとの直接対戦を示す資料ではありません。